プルリクエストに図を載せよう
PRのdescription、目が滑ると思ったことはないだろうか。この記事では、プルリクエストにその変更を代表する一枚〜二枚程度の図を掲載することで、この問題を解決することを提案している。
代表図
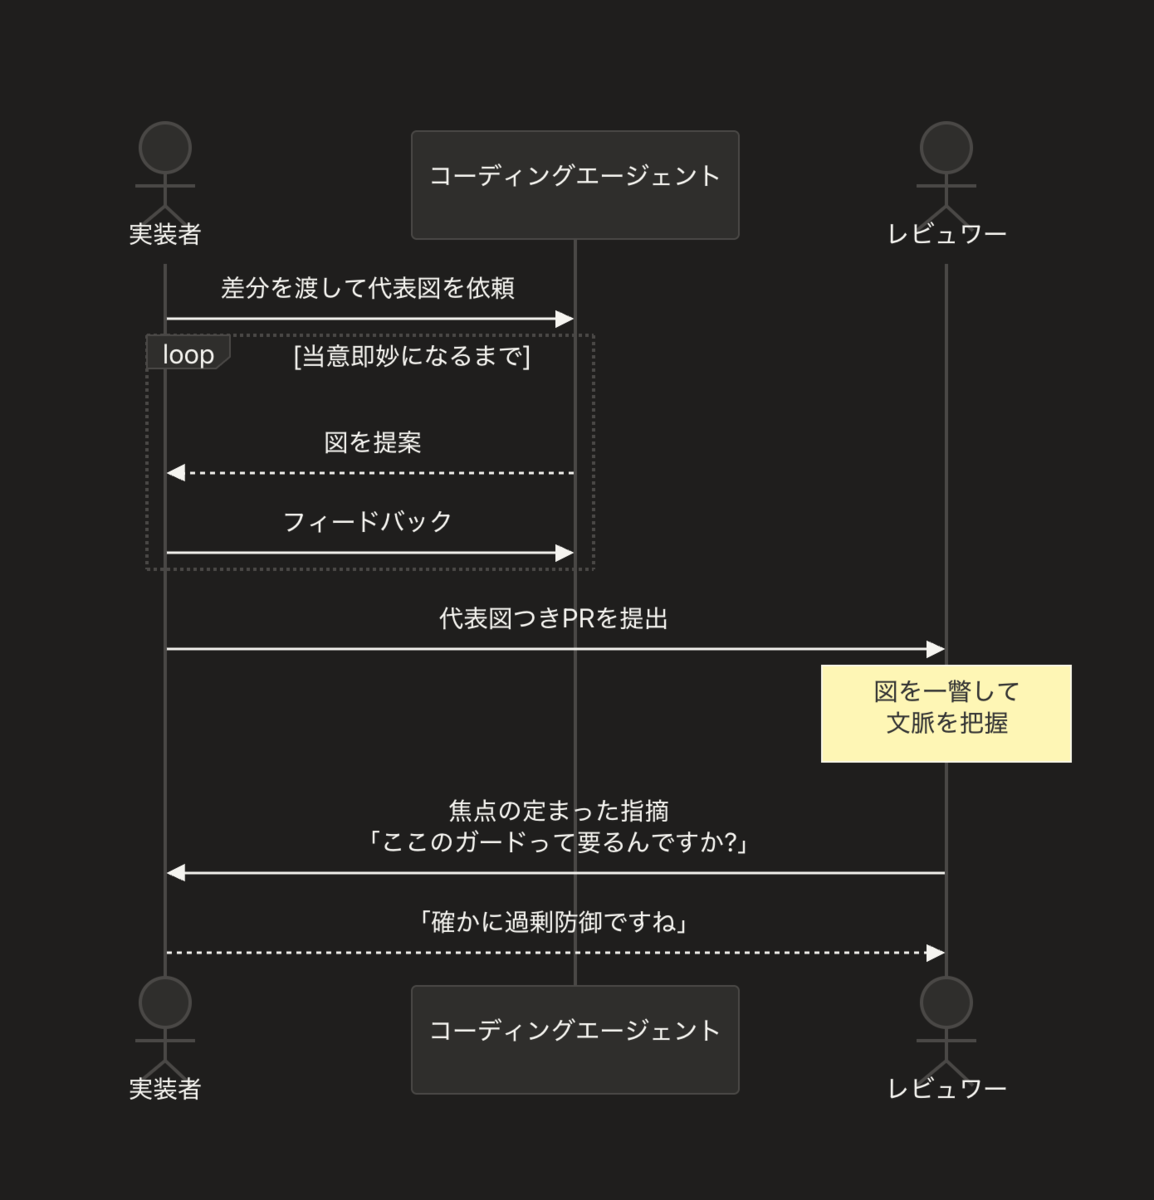
この図は、本記事自体をコーディングエージェントに入力して、代表図(後述)を提案させたもの。何度か人間がフィードバックを入れて完成させた初手で思ったものがほぼ出てきたのでそのまま添付している。
要旨
- レビュワーフレンドリーなdescriptionは、コードレビューに必要な文脈情報が一目でわかる形になっているべき
- コーディングエージェントの存在によって、Mermaid等での作図コストは低下している
- そのPRを代表する図(代表図)を用意するよう心がけることで、この情報を一瞥でわかるように工夫してはどうか
- 試みた範囲では、実際便利である
- 「代表図」は、この文章をもとにコーディングエージェントに書かせたもの
PRのテンプレートは肥大化しがち
ソースコードに載らないコンテキストを扱うため、PRのテンプレートは肥大化することがある。必要な情報を全部載せると気軽に読めるものではなくなってしまうというのは悩ましいトレードオフだ。
descriptionにはいくつかの機能があると思う。たとえば以下のようなものが考えられるが、これに限らないだろう。
- レビュワーがレビューをするために必要な文脈情報を載せる
- 後世の人がその変更がなぜ、どのようになされたのかを把握するための情報を載せる
- 何かしらの自動プロセス*1へのコマンド、情報
- 実装者が覚えておきたい備忘情報(動作確認手順など)
レビュワーが最初に見たいのは、一つめの情報だけである*2。
文脈情報がどこにあるのかが一瞥でわからないdescriptionは、目が滑る。そして、とりあえずコード差分を見たらわかるだろう、ということになってしまって、descriptionを読むのは後回しにされてしまう。
これでは勿体ない。なぜなら、折角書いた文脈情報を知らないままレビュワーがコードを見ることになるので、実装者の準備が一部無駄になってしまうし、レビュワーもコードを読み解くまで何がしたいかわからないことになる。
こういうとき、視覚的な情報整理というのは優れているが、作成コストが高いという問題があった。なので、設計段階などで根を詰めて作るものだったように思う。一般的なdescriptionでは、なるべく言葉を尽くして変更内容を説明しようとする。そして、必要に応じて、設計時に作成した図へのリンクを貼ったりする。
そして、コーディングエージェントが登場する
コーディングエージェントが登場したことで、Mermaidなどを用いた作図コストは劇的に下がった。これを使わない手はない。じっと変更差分を睨んで、この変更は状態管理が焦点になるな、と思ったら、状態遷移図をMermaidで書いてくれ、と依頼すればよい。
続き物のPRなら、シーケンス図やフローチャートを書き、このPRが実現しようとしている範囲を示してくれ、などと依頼することもいいだろう。
いい図が思いつかなければ、「レビュワーにこの変更が行おうとしていることを概説するための図を作りたいので、いくつか提案してほしい」と依頼することもできる。あんまり記号接地している感じのしない提案をしてくることもあるが、フィードバックを重ねるうちに当意即妙な図が提案されてくるはずだ。
こうしてできあがった図を、自分の中では「代表図」と読んでいる。
試みてみた感想
便利である。口頭でPRを説明するときなどは特によい。「この変更の見所は?」「ええっと……この辺で……あれ、違うな、こっちこっち。ここの何行目なんですが」みたいな話をするまでもない。図を見せて、上から順に、あるいは左から右に説明していけばよい。レビュワー、ないしその他紹介を受ける人は、その説明を聞きながら、あれ、ここのガードって要るんですか?みたいなツッコミをしてくれるから、適宜お返事をする。「確かに過剰防御ですね」みたいなことを言って処理を消しても良い。
また、コーディングエージェントに書かせた実装をセルフレビューする意味でもよい。流れを書かせてみると違和感に気づけたりする。そもそもこの変更の核心とはなんぞや、ということを振り返るにも役立つ。自分自身のためにもお勧めである。
YAPC::Fukuoka 2025に行ってきました
YAPC::Kyoto 2023以来2年越しに参加してきた。だいぶ遅くなってしまったけど、今年のうちに記録しておきたい。
YAPC::Kyoto 2023hexa-antenna.hateblo.jp
京都は個人的な事情でたびたび訪れていたけれど、福岡は初めての土地。知らない街を訪れるという体験も楽しみながら、2日間を過ごすことができた。
聴講したトークと感想
HTTP Message Signatures ― HTTPクライアントの身の証を立てる
不特定多数からリクエストを受け付けるが、そのリクエストが誰からのものか、ということは知りたい。そんなケースもあるんだなぁ、と思っていたのですが、実はとても現代的なテーマ。なぜなら、特定の許可を受けたBotからのリクエストは受け付けるが、その他のBotはお断りする、というようなユースケースがこの生成AI時代に生まれているため*1。
Introducing RFC9111
RFC2連発!こちらはキャッシュに関する新たな規格。ちょうど仕事でキャッシュと向き合っていたところだったので興味があった。既存のRFC7234にあった曖昧さを解決してくれる素敵なやつなのだが、今のところあまり広まっていないとのこと。曖昧なまま回っているので、今更厳格化したい需要があまりないらしい。
CDNがキャッシュをするかどうかの判定フローを紹介いただけたのだけど、これが面白かった。「迷ったらキャッシュする」という感じらしい。キャッシュされて困るようなものを配信するときはご注意を。
なぜインフラコードのモジュール化は難しいのか - アプリケーションコードとの本質的な違いから考える
terraformとの付き合いは難しいと思っている。こうした難しさについて、そもそもアプリケーションコードとインフラコードでは性質が異なることが一因ではないかという仮説が提示されていて、面白かった。具体的には、アプリケーションコードは処理に関心があり、インフラコードは状態に関心がある。結果、インフラコードでカプセル化を頑張ると依存関係が見えなくなり、扱いづらくなってしまうとのこと。
「データ無い!腹立つ!推測する!」から「データ無い!腹立つ!データを作る」へ ― ゼロからデータを作り、チームで育てられるようにするまで
トークとしてはやはり無類のもので、到底真似できないな、と慄きながら楽しんでいた。きちんとデータを作ることの重要さは表題の通りだけれど、データを作ることの大変さも丁寧に語られていてよかった。泥臭い戦いの片鱗が語られていたけど、きっともっと込み入ったケースもあるんだろうな……。
なぜThrottleではなくDebounceだったのか? 700並列リクエストと戦うサーバーサイド実装のすべて
ちょっと前に非同期処理関係の仕事をしていたので、関心を持って聞きに行った。ジョブの性質がだいぶ違ったので、Debounceを使えばよかったな、という感じにはならなかったけれど、今後の参考としてはとてもよさそう。現実のユースケースがムズいという話、いろんなところでありますよね……*2。
「バイブス静的解析」でレガシーコードを分析・改善しよう
開発プロセスの改善では、よく「斧を研ぐ時間が無い」みたいなアナロジーが使われる。そういうとき、機械に斧を研がせればいいじゃん、というのが骨子のトークだなと感じた。AIに丸投げではなくて、AIの生成したコードによって開発プロセスを改善することで、最低限のメンテナンス性とアカウンタビリティを確保しつつ、必要工数は最小限にするという発想は、継続的改善に向いていそう。
Agentに至る道 〜なぜLLMは自動でコードを書けるようになったのか〜
技術史のような分野が好きなので、こういう話題は大好き。急に社会に出てきたものが学術的には連綿と研究されてきたんですよ、というような話はいいですね。
人間はOODAループで仕事をしてるんだから、AIもワンショットじゃなくてループ回させればいいじゃんという話は非常に納得感があり、なんなら昔自分が創作で考えた話でもあった。しかし、ロボット工学などの分野で昔から発想がありそうな話題でもあり、それが近年まで生成AIの分野で試されなかったのは何故だろう?というのは不思議なところ。何かしらの技術的制約があった?
SREのためのテレメトリー技術の探究 — モニタリングSaaS開発からAIOps・AIインフラまで by yuuk1
お話自体も面白かったのだけれど、「後から振り返ると、どの研究も同じ課題を別の視点から見る研究をしていた」という話が印象的だった。以前読んだ以下の本でも、著者の方が同じことを書かれていたため。人間、ある種の初期衝動的な問題意識があるものなのかもしれない。
ARA へ捧げる鎮魂歌(レクイエム)
この辺の話、小耳に挟みつつあんまり関わらない領域だったので、面白かった。高邁な理想を掲げて立ち上がった大きなプロジェクトの挑戦と蹉跌。しかし、元となる課題は残っているはずで……。今後の動向が注目されそう。
旧から新へ: 大規模ウェブクローラのPerlからGoへの置き換え
弊社CTOの発表。HTTPリクエストを大量に受ける側、ではなくて、大量に送る側というのは未経験の世界なので、いろいろ普段考えていることと違う部分に気を遣っていて面白かった。
Perl の生きのこり
若かりし頃の自分にとって、Perlというのはなんか箱庭諸島ってやつとかBBSってやつとかを自分のホームページに置こうとするとダウンロードしてきてパーミッションをあれこれしたり、ファイルの先頭行にある # /usr/local/bin/perl みたいなやつを書き換えたりするもの*3だった。そんな時代からの話を技術的視線から聞けたのは面白かった。
Rack、PSGI、WSGIなどのインターフェイスを統一することで、結果として多様性が生まれるという指摘も興味深い。これは、必ずしもソフトウェアエンジニアリングのスコープに閉じた話ではないような気がする。
機密情報の漏洩を防げ! Webフロントエンド開発で意識すべき漏洩ポイントとその対策
フロントエンドにうっかりアクセストークンとかを埋めてしまうようなタイプの「機密漏洩」はイメージしやすいけれど、この発表はまた別のもの。開発中の新機能のコードをいかに隠すか、というのは別の観点。
読む技術・書く技術・伝える技術 - 15年続けて分かった持続可能なオープンソース開発
長く同じことをやり続けるというのはそれだけで偉業。それを実現するには。こういうの、「腕力」「気合い」「好きだから」みたいな話に帰着しがちだと思うので、貴重だと思う。いかに続けるか、という話は、先日のYAPC::Fukuoka 非公式リジェクトコン 2025でも id:magnoliak さんが言及されていた。
ステートレスなLLMでステートフルなAI agentを作る
人間とコミュニケーション可能な機械というのは個人的に関心が強いところなのだが、諸事情で終盤しか見られなかったのが痛い。昔ChatGPTに創作キャラクターのロールプレイをさせてみたことがあるのだが、だんだん出来の悪い二次創作みたいになって困ったことがあった。自分自身のロールプレイに影響されてどんどん特徴を誇張したキャラクターになっていく*4、という感じのことが起きていたと思っている。そのあたり、同じことに困られたりしなかったのか、気になっている。
QNAPのNASをOpenTelemetryで監視したいときはSNMP Receiverを使えるが、設定を書き連ねるのが大変
なぜやりたいか
自宅にQNAPのNASを導入したことは以前の記事で触れた。このNASは便利に使っているのだけれど、何の監視もせずに運用していくのは心配。気付いたらディスク容量がパンパンで大慌て、みたいなことは避けたい。
ふと調べてみると、OpenTelemetryにはSNMP Receiverがあるではないか。NAS側がSNMPを使えることはわかっていたので、お手軽に監視できるのでは?ということで、試してみることにした。
どうやったか
NAS側の設定
以下を辿ればできる。簡単便利。
OpenTelemetry Collectorを動かす
動かし方はいろいろある。本当は、Raspberry Piなどで外部から問い合わせるのが手堅いと思うが、とりあえず手軽にやりたかったので、NASにあるContainer Stationという機能*1を使った。手触りとしてはDocker Composeのラッパーという感じ。NASにあるデータと連携させたいような常駐アプリケーションを置いておくにはよいと思う。あと、データがNASのバックアップ機能によって自然と行われるのも魅力。
OpenTelemetry CollectorのイメージはDockerHubにあるので、これをpullしてきて動かす*2。
OpenTelemetry CollectorがNASにアクセスしてSNMPの値を取得するように設定する
コンテナ内の/etc/otelcol-contrib/config.yamlを編集することで行える*3。設定の方法は以下のページを参照。
つらいのは、OIDを調べるところである。snmpwalkを使って調べようとした時代もあったが、挫折。以下のサイトを参照している。
https://mibs.observium.org/mib/NAS-MIB/
基本的に、テーブルの列を指すOIDを指定すればよいようだ。
お好みの送信先に送る
Collectorが取れるようになれば、あとはOpenTelemetryの仕組みの中でやりたい放題である。今のところ、最近オブザーバビリティプラットフォーム*4として活発な開発が行われていてAPMにも対応した*5Mackerel*6でもよいし、Grafanaなどでもよいだろう。今のところ、自分は上記の二つのプラットフォームに送信してみている。
今後の課題
MIBを調べて一個ずつ設定を書いていくのはあまりにつらい!必要最低限の項目だけならともかく、網羅的にやるならもっといい方法はないのか……。と思っていたら、こんな記事を見つけた。
snmpwalkはPrometheusのSNMP exporterと組み合わせる(設定例)
walkができるのなら、個別のマッピングを人間が書かなくてもいい……?詳しくは調べていないので、今度試してみようと思う。
ぼくの考えた最強のアルゴリズムを雑に検証してみたら、想定通り駄目なアイディアだった話
この記事は、はてなエンジニア Advent Calendar 2024の 29日目の記事です。昨日は id:todays_mitsui さんの「React の className と SolidJS の class」でした。
頼りないアイディア
日の下に新しきものなしという有名な言葉があります。いろんな使われ方がありますが、私は、これを「思いついたことの先行事例がないか考えてみよう」という意味でも捉えています。
さて、私はかねて思っていました。モデル層で書いた状態を判定するためのロジックを永続化層へのクエリでも管理しないといけないのがつらいな、と。我々は、アクティブな状態のユーザーを検索したり、ユーザー管理画面を開いたときユーザーの表に「アクティブ」と表示させたいのであって、別にrepository.findActiveUsersで返ってくるレコード全てに対してuser.isActiveがtrueであることを確認したりしたいわけではないはずです。そんなわけで、なんとかSQLはシンプルに保ちつつ、アプリケーション側でフィルタする方向に倒せないかなと考えていたのですが、ある日思いついたのです。
「ゆるくSQLで絞り込んでからアプリケーションできちんと絞り込む。欲しい件数に足りていなければ、カーソルを動かしてもう一回クエリ、もう一度絞り込む。件数が十分になったら打ち切って結果を返す。どうだ!これなら完璧なのでは?」
自分は天才なんじゃないかと5秒くらい思いましたが、日の下に新しきものなし、です。いいアイディアなら、誰かが思いついて実用されているんじゃないか?調べてみると、先行事例を見つけることはできませんでした。どうにも雲行きが怪しいですね。自分はヘンテコな思いつきをしてしまったのではないか?
まあ、冷静になって机上で考えただけでも不穏な点はあります。例えば、テーブル全体を走査して結果が0件になるような状況なら、レコード数 / ページサイズ だけのクエリが発行されることになるでしょう。基本的にはすぐ見つかるが、時々例外的に除外したいものが混じっている、程度の状況にしか使えないのではないかという予想はすぐにつきます。
それでも試してみる
予想を立てて諦めるのもいいのですが、目の前にあるキーボードをちょっと叩けば、この程度のアイディアの検証はすぐできるはずです。ちょうどGoの勉強をしたかったこともあり、実際にやってみることにしました。
1回のクエリに100ms掛かる検索処理で一定数のレコードを取得したあと、乱数によって一定確率でアプリケーション側のフィルタによって絞られる。件数が必要数に足りなければ、もう一度クエリを投げて同じことをする。必要数を満足するまでこれを繰り返す。コードにすると、以下のような処理です(全体は上記リポジトリ参照)。
func Find(after FooId, limit uint, isActiveThreshould uint) []Foo {
    r := rand.New(rand.NewSource(time.Now().UnixNano()))
    randomNumber := r.Intn(100)
    rng := lo.Range(int(limit) * 2)
    time.Sleep(QUERY_EXECUTION_TIME_SECOND)
    return lo.Map(rng, func(item int, index int) Foo {
        return Foo{
            ID:       FooId(item),
            IsActive: randomNumber < int(isActiveThreshould),
        }
    })
}
このようなアルゴリズムによって得られた結果がこちらになります。
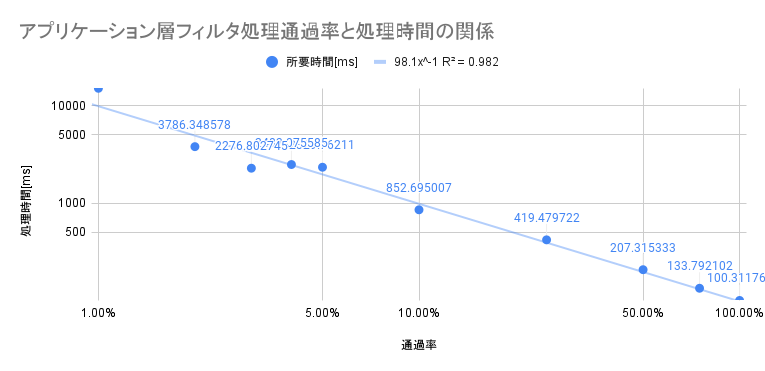
急激に処理時間が延びていく様子がわかります。うーん。厳しい!通過率50%までは要件によってはギリギリ許容されるかな~という気もしますが、そもそもクエリをちゃんと書いていたら不要な心配なわけで、あまり検討されないのもむべなるかな、という結果に終わりました。予想を裏切らない結果ですね。
感想
このように手軽にベンチマークが書けるエコシステムが整っているのはGoのいいところですね。考え込む前にまず実験!という動きをするにはとても便利です。
今回考えたアイディアは日の目を見ませんでした。似たような、しかし微妙に違う絞り込みロジックが沢山あるとき、それぞれのクエリに名前を付けていくのが結構大変なんですよね。しかし、そうした問題を解決する方法としては、別の方法を考えなくてはいけないようです。モデル層のロジックとクエリそれぞれを考えなくてはいけないことは受け入れて、片方を変えたときもう一方の変更が漏れないような方法を工夫する方が筋がよいのかもしれません。
はてなエンジニア Advent Calendar 2024、明日は id:yutailang0119です。
LambdaでS3イベント通知を受け取ってHTTPリクエストを送信したいとき気をつけること
S3に何らかのファイルが置かれたとき、そのことをアプリケーションに通知したいとき、S3イベント通知を使うと便利なのだが、いくつかハマりどころがあったので、備忘しておく。
S3イベント通知は、特定のバケットにおいて何らかの操作がなされたとき、そのことを連携しているサービスに通知してくれる。コンソールをポチポチするだけでイベントオブジェクトをLambdaが処理してくれるようになるので大変便利だ。
このイベントオブジェクトの構造は以下のようになっている。*1
{
   "Records":[
      {
         "eventVersion":"2.2",
         "eventSource":"aws:s3",
         "awsRegion":"us-west-2",
         "eventTime":"The time, in ISO-8601 format, for example, 1970-01-01T00:00:00.000Z, when Amazon S3 finished processing the request",
         "eventName":"event-type",
         "userIdentity":{
            "principalId":"Amazon-customer-ID-of-the-user-who-caused-the-event"
         },
         "requestParameters":{
            "sourceIPAddress":"ip-address-where-request-came-from"
         },
         "responseElements":{
            "x-amz-request-id":"Amazon S3 generated request ID",
            "x-amz-id-2":"Amazon S3 host that processed the request"
         },
         "s3":{
            "s3SchemaVersion":"1.0",
            "configurationId":"ID found in the bucket notification configuration",
            "bucket":{
               "name":"bucket-name",
               "ownerIdentity":{
                  "principalId":"Amazon-customer-ID-of-the-bucket-owner"
               },
               "arn":"bucket-ARN"
            },
            "object":{
               "key":"object-key",
               "size":"object-size in bytes",
               "eTag":"object eTag",
               "versionId":"object version if bucket is versioning-enabled, otherwise null",
               "sequencer": "a string representation of a hexadecimal value used to determine event sequence, only used with PUTs and DELETEs"
            }
         },
         "glacierEventData": {
            "restoreEventData": {
               "lifecycleRestorationExpiryTime": "The time, in ISO-8601 format, for example, 1970-01-01T00:00:00.000Z, of Restore Expiry",
               "lifecycleRestoreStorageClass": "Source storage class for restore"
            }
         }
      }
   ]
}
なので、追加されたファイルに何らかの処理をしたいのならば、Records[].s3.object.keyをもとにバケットにアクセスし、あれこれ触ればよい。
どこにハマったか
LambdaのJavaScriptランタイムに手軽なHTTP通信用のライブラリは組み込まれていない
コンソールでポチポチしてちょっとしたHTTPリクエストを送るものを探索的に実装したかったので、JavaScriptでLambdaを書いていた。こういう感じなので、組み込まれていないライブラリに依存したコードは書きたくない。こんなとき、Lambdaではどうしたらいいのだろう?
最新のNodeJSにはfetch APIが登場しているが、LambdaのNodeJSランタイムのバージョンは20で、ギリギリ安定化されていないので、使えない。11月には22のランタイムが登場するようなので、ギリギリ間に合わなかったようだ。
そんなわけで、httpsというモジュールを使う必要がある。
使い心地については、リンク先にある以下のサンプルコードがわかりやすいと思う。
const https = require('node:https');

const options = {
  hostname: 'encrypted.google.com',
  port: 443,
  path: '/',
  method: 'GET',
};

const req = https.request(options, (res) => {
  console.log('statusCode:', res.statusCode);
  console.log('headers:', res.headers);

  res.on('data', (d) => {
    process.stdout.write(d);
  });
});

req.on('error', (e) => {
  console.error(e);
});
req.end();
見ての通り大分低レベルなAPIで、手軽なスクリプトを書く目的からするとtoo muchな感じがある。自分は、最後にreq.end()を呼ばないと通信が終了しないことに気付かず、Lambdaを何度かタイムアウトさせてしまったことをここに懺悔したい。
httpsでリクエストを組み立てるとき、Content-Lengthの計算方法には工夫が要る
上記の通り、だいぶ低レベルなAPIだから、POSTリクエストを送るときにリクエストボディを見てContent-Lengthを良い感じに設定してくれる仕組みなどはないようだ。なので、自分で計算する必要がある。
このとき、サンプルコードなどを見ながら、何気なくこんな書き方をして大失敗をした。
const payload = JSON.stringify(payloadObject);
const options = {
  method: 'POST',
  headers: {
    'Content-Length':  payload.length
  }
};
なぜか?Content-LengthとString.lengthの仕様を見ればわかる。
Content-Length エンティティヘッダーは、受信者に送信されるエンティティ本文の長さをバイト単位で示します。 developer.mozilla.org
length データプロパティは、String オブジェクトの文字列長を UTF-16 コード単位の数で表します。 developer.mozilla.org
長さの定義が揃っていないのである!このため、うまくペイロードを送信できず、受付先の処理が失敗していた。この不具合は、ASCII文字のみのファイル名では顕在化しないため、原因箇所に気付くのが遅れてしまった。
解決するには、Buffer.byteLength(payload, 'utf8') のように書けばよいようだ。
S3イベント通知では、keyに日本語が含まれる場合、エスケープされる
読んで字のごとしである。keyに日本語が含まれないケースでは成功するのに、日本語が含まれると失敗するという不具合を調べていたところ、S3イベント通知のオブジェクト内ではkeyがUTF-8のエスケープ文字列に変換されていた。これをそのままHTTPリクエストに詰めて別アプリケーションに送信すると、実際と異なるキーにアクセスしにいって空振りしてしまう。これを回避するには、Lambda内で文字列のエスケープを解除してやるとよい。エスケープの解除は、decodeURIを使えばよい。
まとめ
あまり触ったことのない道具を使ったら火傷した、という話に集約されると思う。手元でちょっとしたお試し、という段階でこういうことに気づけたのはよかったけれど、ドキュメントを斜め読みせず見ていたらもっと事前に気づけたところもありそう。なので、ドキュメントをもっときちんと読めると良いですね、という教訓で締めくくりたい。
「初めてのGo言語」を読んだ

Goと仲良くしていく必要性を感じていたので、書店でいろいろ見比べて買ってきた。プログラミングしたことない人向けの記述は不要だったので、Go特有の概念や考え方がよくまとめられているのは非常に使いやすいと感じた。通読しても良いし、必要なときにリファレンスとして紐解くにも便利な構成になっているから、今後も机のそばに置いておきたい。
以下は本書に基づくGoに対する第一印象
基本的にはふむふむという感じで読んでいた。エラーを例外として扱わず関数の戻り値として返すコンセプトなどは今も仕事でやっていて困っていないし、よいのではないか。あまり並列処理を明に扱った経験はないのだけど、ゴルーチンは便利そう。以前別の言語で軽く触ったときは、同期処理とつなぎこむところがもう少しおまじないめいていて難しかった記憶がある。うまい抽象化ができているんだと思う。
なるべく安全に寄せて、便利な自動変換は予期せぬ不具合の温床になる、明示的にできるものは明示的にしようという考え方自体は理解できた。しかし、イミュータブルみたいな話になると、「ここは人間を信頼しよう」みたいな話になるのが呑み込みきれなかった。もう一つのコンセプトとして高速にコンパイルしたいという事情があって、トレードオフの結果ということなんだろうか?仮にそうだとすると、一般的な開発環境の計算速度が向上したり、コンパイル最適化の技術が進歩していけば、明示的にイミュータブルであると宣言できるようになるのだろうか*1?
さて、ここまでは机上の話。今度は実際に手を動かして何かを作ってみたい。
初のNASを迎え入れて対峙したいくつかの課題とその打開策など
まとめ
- NASを買った
- バックアップにはS3 Glacier Deep Archiveを採用したが、いくつか注意点がある
- IOPSが足りない気がして設定をあれこれ見直したけど、効果を定量的に測定しきれていない
- 折角買ったのでいろいろ活用していきたいね
なぜNASを買ったか
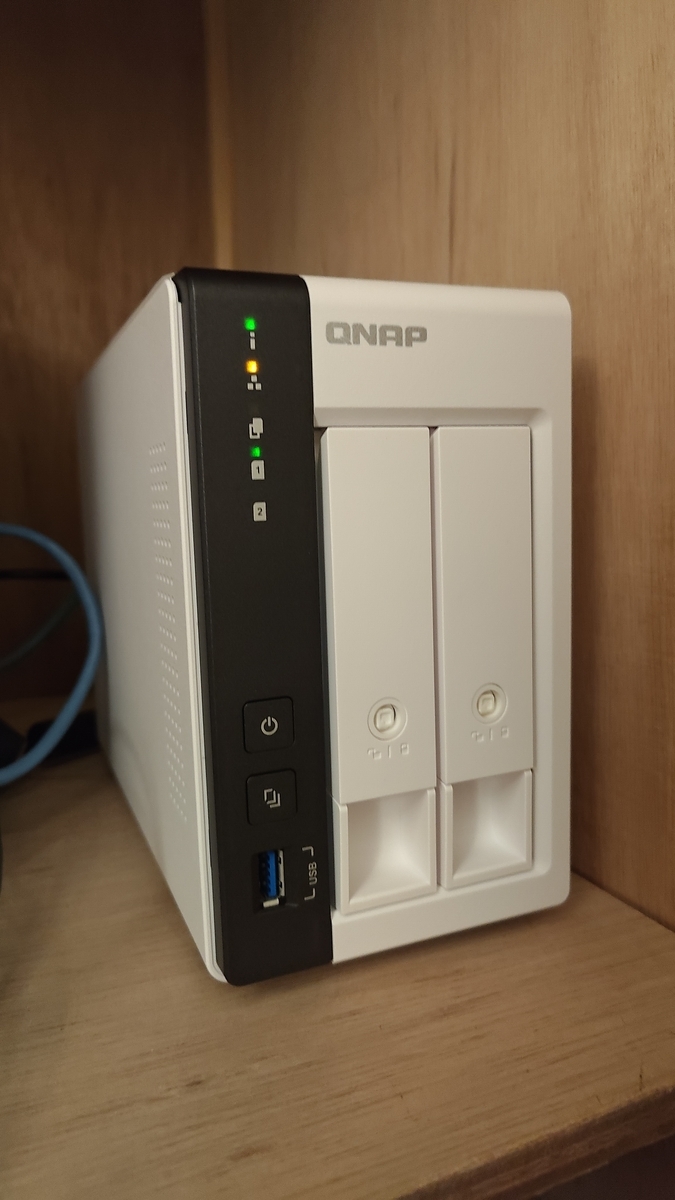
同人活動などもやっている都合、大容量のファイルをずっとアーカイブしたい事情があった。これを今まではDropboxでやってきていたのだけど、いい加減なんだか複雑な気持ちになってきたのだ。
もちろん、Dropboxは素晴らしいサービスだ。ファイルの共有も簡単にできるし、バージョン管理されているから、操作ミスでファイルを壊してしまってもなんとかなる可能性が高い。お金さえ払えば、それなりのディスク容量も提供してくれる。
ただし、あくまでデータは人に預けたものだし、毎月1000円以上のお金を払う必要はある。その価値はあるけれど、今後もずっと払い続けていく固定費と考えると悩ましいものがあった。
とはいえ今まではそうしてきたし、大きな不満はなかった。ではなぜNASを買ったかというと、以下のような事情がある。
- ライフステージが変わり、同人活動以外でも共有すべきデータが増えてきた
- 音楽や写真などのデータが溜まってきていて、Dropboxにバックアップすべきデータとそうでないデータに仕分けるのが苦痛になってきた
- 職業柄、フルマネージドのサービスばかり触っていてもよくないと思った
どんなNASを買ったか

こんなのを買った。ディスク容量は4TBだが、もちろん増設はできる。RAIDは今のところ組んでいない。これによる信頼性の低下については、後述するがS3 Glacierへのバックアップによって担保したいと考えている。
なぜこれにしたかというと、以下のようなことを考えたからだ。
- HDDの交換が簡単そうな作りになっていた
- マルチギガビット対応なので、10Gbps環境のおうちネットワーク環境を最大限生かせる
- 機械学習による画像のタグ付け機能などが充実していた
課題と対応
バックアップをどうするか
NAS一台では故障のリスクは無視できない。ディスク破損によりデータが飛んだりしたら最悪だ。このリスクは、RAIDを組んでも低減しきれないと考えたので、RAIDは組まないことにした。代わりに採用したのが、S3 Glacier Deep Archiveへのバックアップだ。
上記の記事を大いに参考にした。ただし、この後NASのOSがアップデートされたのか、AWS側でライフサイクルポリシーを変更しなくても、直接S3 Glacier Deep Archiveのストレージクラスを指定してアップロードできるようになったようだ。便利便利。
クラウドストレージを脱出して結局クラウドストレージに依存してるじゃん、という気はするけれど、コストを計算してみると月々数ドルとかになりそうだったので許容した。
ただし、この点については二つ失敗をしたのでここに書き留めておく。注意されたい。
初回のバックアップはそれなりに費用が掛かる
当たり前の話ではある。しかし、初回は試行錯誤も発生するので尚更お金が掛かりやすいということに留意したほうがよい。多分、最初はあまりデータ量のない状態で何度か試すとよかったのだと思うけど、一度入れてしまってからバックアップを取り始めたから後の祭りである。
アップロードに失敗した場合にゴミデータが残り続けることに注意
コスト状況を確かめようとCost Explorerを見ていたら、DeepArchiveStagingStorageという見慣れない費用が随分掛かっていた。
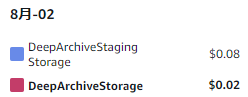
なんだこれ?調べてみると、マルチパートアップロードが途中で止まった場合に残ったデータたちらしい。
Glacier Deep Archive ストレージクラスのオブジェクトの CompleteMultipartUpload (複数アップロード完了) リクエストが完了する前に、マルチパートオブジェクトに使用されているバイト数。
何度かバックアップに失敗したので、そのときに作られてしまったのだろう。これはしかるべきライフサイクルポリシーを設定することで、定期的に削除することができる。
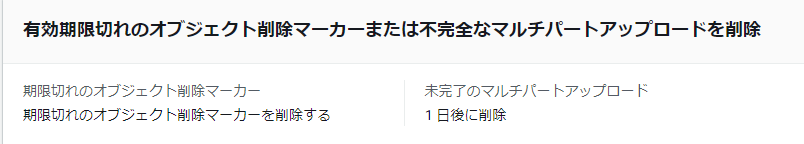
この点にメスを入れることで、一日0.2USD程度で大量のデータを保存できるようになった。やったね。
なんか転送が遅いんだけど
SMBでマウントしていると、なんだか転送が遅い気がした。具体的に言うと、RPGツクール製のゲームを起動するときめちゃくちゃ待たされる、など*1。 スループットは数百Mbps前後出ていそうなので、IOPSが足りていないのではないか*2。そう考えて、非同期IOを有効化するなどの手を打ったらだいぶ改善した気がする。これについてはあまり定量的な議論ができておらず、やや歯がゆい。うまいモニタリングの方法はないだろうか。
非同期IOはクラッシュ時などにデータ消失のリスクもあるはずだけれど、今回はそれを容認することにした。大量のファイルを転送するときはカット&ペーストでなくコピペしてから削除するような小技を使うことになるかもしれない。
NASを導入して嬉しかったこと
メディアサーバーが家で稼働する形になり、家のオーディオ機器から手軽に音楽が再生できるようになったのはよかった。オーディオ機器からの再生の都合でストリーミングサービスに頼りがちになっていたけれど、これでおうちの音源を手軽に流すことができる。
あとは、Dropboxの容量節約のためにクラウドストレージを複数管理するような苦しみから解き放たれたのも嬉しいですね。
今後やりたいこと
NASのモニタリング
今はほぼモニタリングできていない。Mackerelなどを導入して稼働状況を監視できるようにしたい。Mackerelのインストールはコマンド一発というわけにはいかないようだけど、以下のようなグッズを提供してくださっている方がいるところまでは調べることができた。
SSDキャッシュの導入
SATAポートが一つ余っているので、SSDキャッシュを使えば高速化が図れるのではないか。そのうち懐が暖まったらやってみたい。
UPSの導入
なんとUPSがない。絶対いい状態ではないけれど、結構高いのよね……。SSDキャッシュよりは優先度高いと思う。おすすめUPS情報お待ちしています。
アプリケーションを動かしてみる
QNAPのNASはコンテナイメージを持ってきて稼働させることができるようだ。折角なので、この辺をうまく使って面白いことができないか模索したい。
*1:ゲームはローカルに置けという主張は正しいけど、軽いゲームくらいならNASに置けないかなと思ったのだ
*2:今時のツクールはJavaScriptで動いているので、結構な数の.jsファイルを転送していそう
